 ایرانیان AI
برای گرفتن کمک از هوش مصنوعی معمولاً لازم نیست تمام اطلاعات واقعی یک مسئله را وارد کنید. گاهی چند عدد نمونه، یک نام جایگزین و توضیح روشن رابطهها کافی است. این مقاله یک روال عملی برای آمادهکردن متن، تصویر و صدا پیشنهاد میکند تا دادهٔ مرتبط را نگه دارید و جزئیات غیرضروری را پیش از ارسال کنار بگذارید.
اول بپرسید کدام داده برای این کار ضروری است
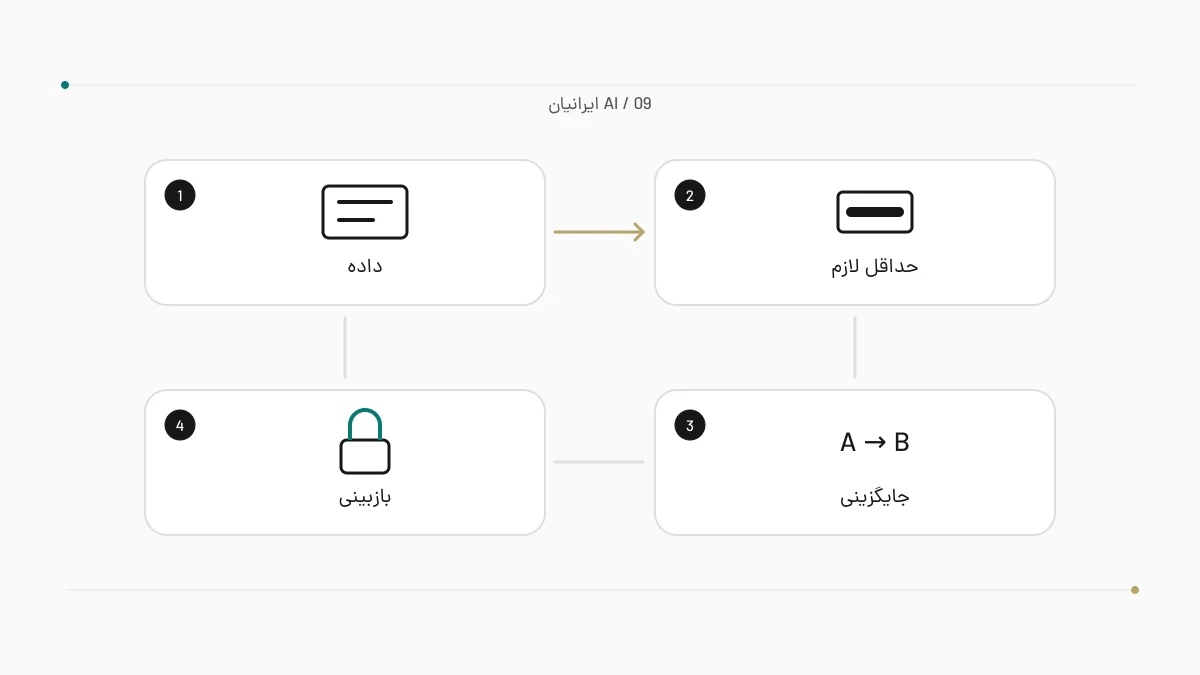
اگر میخواهید لحن پاسخ به مشتری را اصلاح کنید، احتمالاً نام کامل، نشانی منزل یا شمارهٔ واقعی سفارش برای تمرین لازم نیست. متن مسئله و وضعیت قطعی سفارش کفایت میکند. برای تحلیل یک جدول هم ممکن است ستون نام اشخاص بیارتباط باشد، اما رابطهٔ اعداد اهمیت داشته باشد.
پیش از ارسال، دادهها را به دو دستهٔ لازم و غیرلازم برای همین هدف تقسیم کنید. این تصمیم وابسته به کار است؛ نسخهٔ سانسورشدهای که همهٔ زمینه را حذف کند هم ممکن است پاسخ بیربط بسازد. هدف، نگهداشتن اطلاعات کافی با کمترین جزئیات شناساییِ نامرتبط است.
جایگزینی را یکدست و قابل پیگیری انجام دهید
نامها را با برچسبهایی مانند «مشتری الف» و «تأمینکننده ب» جایگزین کنید و همان برچسب را در کل نمونه نگه دارید. اگر یک نفر در چند ردیف حضور دارد، تغییر اتفاقی نام او میتواند تحلیل را بههم بزند. رمز، کد ورود و کلید دسترسی را اصلاً در نمونه قرار ندهید.
در مثال پاسخگویی به مشتری، لازم نیست شمارهٔ سفارش را با بخشی از همان شماره نگه دارید؛ برچسب «سفارش نمونه» کافی است. اگر زمان یا مبلغ واقعی برای مسئله لازم نیست، از عدد فرضی استفاده کنید و صریح بنویسید نمونه است. رابطهٔ مهمِ اعداد را برای تمرین حفظ کنید.
تصویر و صدا را هم مثل متن بررسی کنید
در تصویر فقط محتوای مرکزی را نبینید؛ اعلانها، نام حساب، نوار مرورگر و نوشتههای گوشهٔ صفحه ممکن است اطلاعات نامرتبط داشته باشند. یک تصویر جدا از ناحیهٔ لازم تهیه کنید و آن را پیش از ارسال دوباره باز کنید تا پوششها واقعاً اعمال شده باشند.
در صدا، نام افراد یا اطلاعات تماس ممکن است میان جملهها بیان شده باشد. برای تمرین بهتر است خودتان یک نمونهٔ غیرحساس ضبط کنید. فایل را با دقت انتخاب کنید؛ داشتن نام مشابه به معنی محتوای یکسان نیست. این روال دربارهٔ آمادهسازی ورودی است و ادعای ناشناسسازی کامل داده ندارد.
قواعد سرویس و خروجی را با هم بررسی کنید
پیش از ارسال دادهٔ واقعی، سیاست فعلی حریم خصوصی و شرایط استفادهٔ همان سامانه را بخوانید. از روی عمومی یا پولیبودن سرویس دربارهٔ شیوهٔ نگهداری داده نتیجهگیری نکنید. برای ایرانیان AI، پیوند سیاست حریم خصوصی و شرایط استفاده در سایت رسمی در دسترس است.
خروجی را هم قبل از بازنشر بررسی کنید؛ ممکن است بخشی از اطلاعات ورودی را عیناً تکرار کرده باشد. ریسک حریم خصوصی در چارچوب NIST برای هوش مصنوعی مولد نیز مطرح شده است. روشهای این مقاله یک روال کاری پیشنهادیاند و تضمین حذف همهٔ امکانهای شناسایی نیستند.
آماده برای شخصیسازی
نمونهٔ درخواست
در نمونهٔ زیر فقط به اصلاح لحن کمک کن. نامها و شمارهها فرضیاند. هیچ اطلاعات تماس یا شناسهٔ تازهای نساز. اگر برای انجام کار به دادهٔ بیشتری نیاز داری، نوع داده را بپرس و از درخواست اطلاعات شناساییِ نامرتبط خودداری کن. نمونه: [متن آمادهشده با نامهای جایگزین]
پیش از ادامه بررسی کنید
- فقط دادهٔ لازم برای همین کار را نگه داشتهام.
- تصویر و فایل نهایی را پس از آمادهسازی دوباره دیدهام.
- خروجی پیش از بازنشر از نظر اطلاعات شخصی بررسی شده است.
پرسشهای رایج
آیا حذف نام، فایل را کاملاً ناشناس میکند؟
لزوماً نه؛ ترکیب زمان، مکان یا جزئیات دیگر ممکن است همچنان شناسایی را ممکن کند. فقط نام را معیار قرار ندهید.
از کجا سیاست سامانه را بخوانم؟
صفحهٔ حریم خصوصی و شرایط استفادهٔ رسمی ایرانیان AI را بخوانید؛ اگر برای دادهٔ موردنظر ابهام باقی است، پیش از ارسال از پشتیبانی سؤال کنید.